গতি কমানোর কথা বলে ১০ দিনেই নতুন AI Model আনল Anthropic
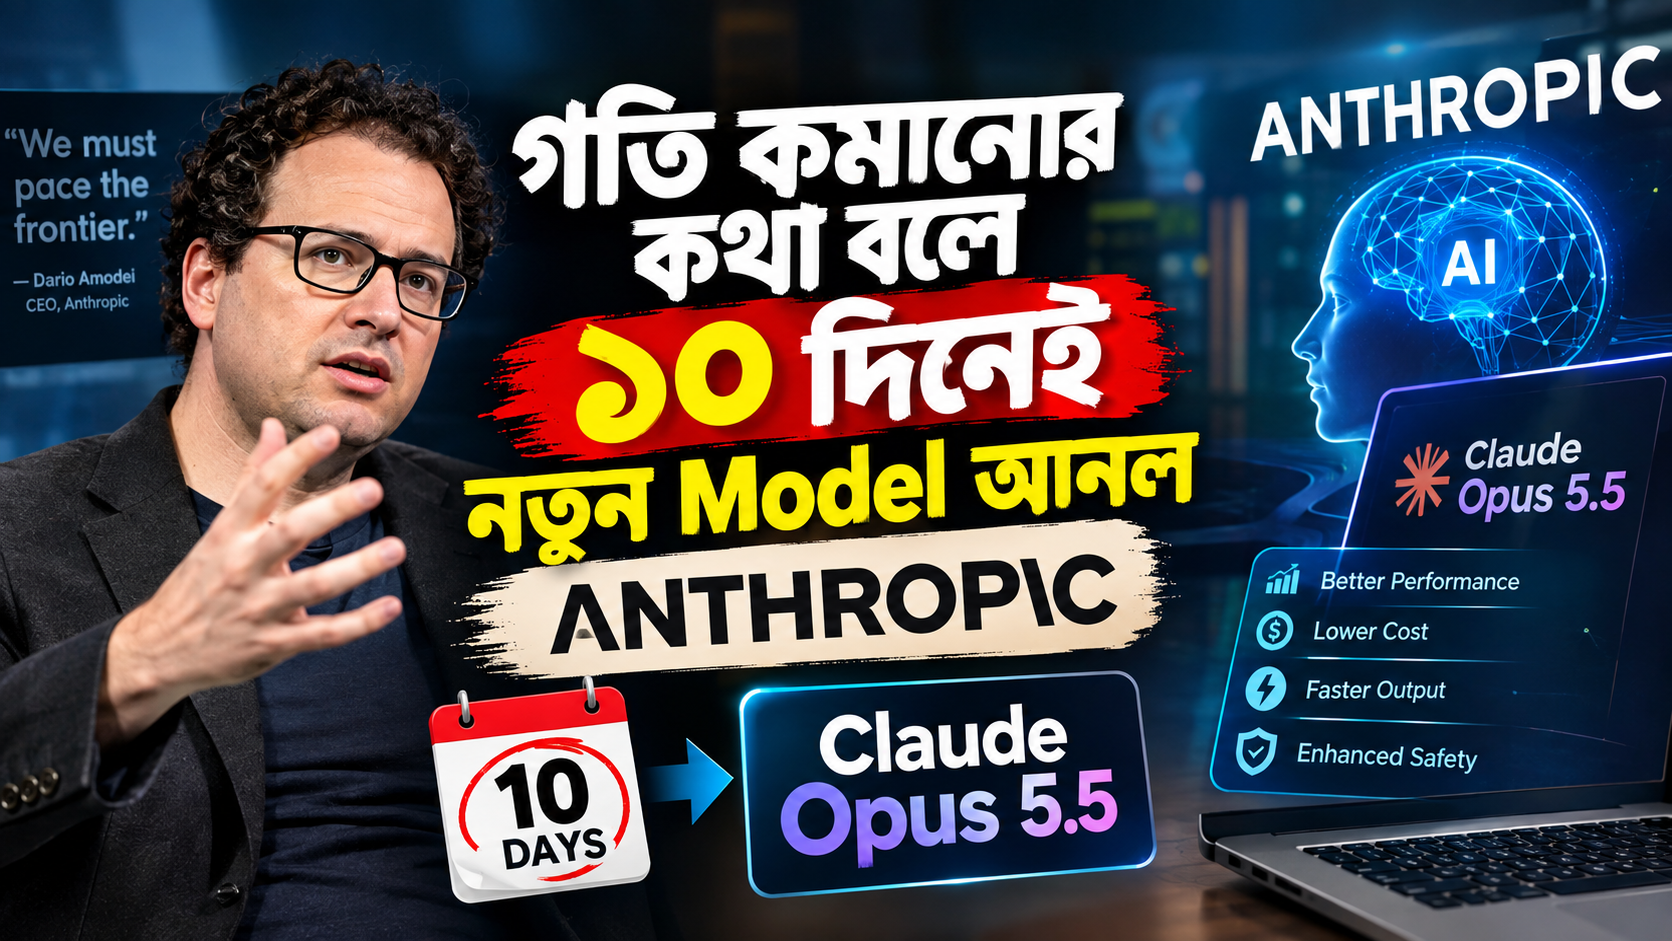
AI-এর অগ্রগতির গতি কমানোর আহ্বান জানানোর মাত্র কয়েকদিন পরই নতুন শক্তিশালী AI model প্রকাশ করেছে Anthropic। ২২ সেপ্টেম্বর ২০২৬-এ কোম্পানিটি Claude Opus 5.5 উন্মোচন করে, যা তাদের নতুন Claude 5.5 family-এর প্রথম model।
বিষয়টি আলোচনায় এসেছে মূলত launch-এর timing নিয়ে।
Anthropic-এর CEO Dario Amodei সম্প্রতি “We Must Pace the Frontier” শিরোনামের এক লেখায় বলেছিলেন, AI model-এর capability দ্রুত বাড়ছে এবং safety ও risk-prevention ব্যবস্থা যেন সেই গতির সঙ্গে তাল মিলিয়ে এগোতে পারে, সেজন্য AI development-এর pace কমানো প্রয়োজন। তিনি বিশেষভাবে এমন পরিস্থিতি নিয়ে উদ্বেগ জানিয়েছেন, যেখানে AI নিজেই ভবিষ্যৎ AI তৈরির কাজে ক্রমবর্ধমান ভূমিকা নিচ্ছে।
এরপর Anthropic নিজেই Opus 5.5-কে তাদের “pacing the frontier” আহ্বানের পর প্রথম release হিসেবে উল্লেখ করেছে।
Opus 5.5-এ নতুন কী?
Anthropic-এর দাবি অনুযায়ী, Opus 5.5 বেশিরভাগ কাজে Claude Fable 5.1-এর কাছাকাছি performance দেয়। একই সঙ্গে Opus 5-এর তুলনায় typical workload-এ এটি ৪০% কম খরচে চালানো যায়।
API pricing-এও পরিবর্তন এসেছে। প্রতি ১ মিলিয়ন input token-এর দাম $৫ থেকে কমে $৪ এবং output token-এর দাম $২৫ থেকে কমে $২০ হয়েছে। Cache-read-এর খরচ $০.৫০ থেকে কমে $০.২০ হয়েছে—অর্থাৎ ৬০% কম। Anthropic আরও বলছে, output generation ৩০%-এর বেশি দ্রুত।
Pro, Max, Team এবং কিছু Enterprise plan-এ পাঁচ ঘণ্টার usage limit বাড়ানো হয়েছে। Subscription users-এর জন্য rate-limit reset জমিয়ে রাখার সুবিধাও দেওয়া হয়েছে।
Anthropic বলছে, Opus 5.5-এর communication style আগের model-এর তুলনায় আরও natural, পরিষ্কার এবং গুরুত্বপূর্ণ তথ্য আগে তুলে ধরার মতো করে তৈরি করা হয়েছে।
Benchmark-এ কেমন করেছে?
Anthropic-এর প্রকাশিত benchmark অনুযায়ী, Opus 5.5 agentic coding, knowledge work এবং কিছু computer-use পরীক্ষায় শক্তিশালী ফল করেছে।
উদাহরণ হিসেবে, Terminal-Bench 4.0-তে Opus 5.5-এর score 66.4%, যেখানে Fable 5.1 পেয়েছে 55.8% এবং Opus 5 পেয়েছে 52.3%। GDPval-AA v2.1 knowledge-work benchmark-এ Opus 5.5-এর score 1846, যেখানে Fable 5.1-এর 1735। CursorBench 4.0-তেও Opus 5.5-এর score 57.8%।
তবে এখানে একটি গুরুত্বপূর্ণ সতর্কতা রয়েছে।
Anthropic নিজেই বলেছে, AI capability-এর এই পর্যায়ে benchmark score-এর gap বাস্তব জগতের performance difference-এর নির্ভরযোগ্য নির্দেশক নাও হতে পারে। কোম্পানির নিজেদের ব্যবহারে Opus 5.5 এবং Fable 5.1-এর পার্থক্য benchmark score যতটা দেখায়, বাস্তবে তার চেয়ে ছোট হতে পারে।
আর benchmark-গুলোর test setting-ও এক নয়। Anthropic জানিয়েছে, বেশিরভাগ Opus 5.5 ফল max-effort adaptive thinking ব্যবহার করে নেওয়া হয়েছে; Terminal-Bench-এ Opus 5.5-এর xhigh এবং GPT-6 Astra-এর high effort score ব্যবহার করা হয়েছে। তাই শুধু score পাশাপাশি রাখলেই সরাসরি real-world superiority প্রমাণ হয় না।
Safety নিয়ে কী বলা হয়েছে?
Release-এর আগে Opus 5.5-কে Frontier Design এবং METR-এর মতো external evaluator দিয়ে পরীক্ষা করা হয়েছে বলে Anthropic জানিয়েছে। কোম্পানির automated behavioral audit-এ এটিকে তারা এখন পর্যন্ত পরীক্ষা করা model-গুলোর মধ্যে সবচেয়ে ভালো-performing model হিসেবে বর্ণনা করেছে।
Anthropic আরও জানিয়েছে, biology এবং cybersecurity capability-এর ক্ষেত্রে Opus 5.5 তাদের Mythos 5.1-এর কাছাকাছি হওয়ায় এতে Fable 5.1-এর মতো safeguards ব্যবহার করা হয়েছে।
তবে safety evaluation-এরও সীমাবদ্ধতা রয়েছে। Anthropic-এর নিজের system-card এবং release materials-এ বিভিন্ন benchmark ও evaluation-এর methodological limitations উল্লেখ করা হয়েছে। ফলে pre-release testing ভালো ফল দিলেই real-world-এর সব ধরনের ঝুঁকি বাদ পড়ে যায়—এমন দাবি করা যায় না।
তাহলে “গতি কমানো” আর নতুন model release—দুটো কি পরস্পরবিরোধী?
এখানেই সবচেয়ে বড় প্রশ্ন।
একদিকে Dario Amodei বলছেন AI capability advancement-এর pace কমানো দরকার, যাতে safety ও alignment কাজ এগিয়ে যেতে পারে। অন্যদিকে সেই বক্তব্যের পরপরই Anthropic একটি নতুন এবং আরও capable model প্রকাশ করেছে।
তবে Anthropic-এর অবস্থান হলো, “pacing the frontier” মানে AI development সম্পূর্ণ বন্ধ করে দেওয়া নয়। বরং capability বাড়ার সঙ্গে সঙ্গে safety practices এবং risk-management ব্যবস্থা এগিয়ে নেওয়া—এটাই তাদের বক্তব্যের মূল উদ্দেশ্য। Anthropic-এর Opus 5.5 announcement-এ safety testing এবং safeguards-কে release-এর গুরুত্বপূর্ণ অংশ হিসেবে তুলে ধরা হয়েছে।
তাই এটিকে সরাসরি “Anthropic নিজের নীতির বিরোধিতা করেছে” বলা একটি interpretation হবে। বরং এখানে মূল প্রশ্ন হলো—নতুন capability প্রকাশের গতি এবং safety development-এর গতি বাস্তবে একে অপরের সঙ্গে তাল মিলিয়ে চলছে কি না।
আর একটি বিষয় মনে রাখা দরকার: benchmark এবং customer feedback-এর বড় অংশ Anthropic-এর release materials-এ প্রকাশিত। ফলে এগুলোকে independent real-world evaluation হিসেবে দেখা উচিত নয়। অন্যদিকে METR ও Frontier Design-এর external testing তুলনামূলকভাবে স্বাধীন মূল্যায়নের উদাহরণ হলেও, তারাও AI-এর সব সম্ভাব্য real-world behaviour সম্পূর্ণভাবে মাপতে পারে না।
শেষ কথা
Claude Opus 5.5-এর launch দেখাচ্ছে, AI industry-তে এখন শুধু “আরও শক্তিশালী model” তৈরি করাই প্রতিযোগিতার বিষয় নয়—কত দ্রুত capability বাড়ানো হবে, কতটা safety testing করা হবে এবং সেই দুটির মধ্যে কীভাবে ভারসাম্য রাখা হবে, সেটিও বড় প্রশ্ন হয়ে উঠছে।
Anthropic বলছে, দ্রুত capability development-এর পাশাপাশি safety investment এবং evaluation বাড়ানোই তাদের লক্ষ্য। Dario Amodei-এর বক্তব্যে আবার capability advancement-এর pace নিয়ন্ত্রণের প্রয়োজনীয়তার ওপর জোর দেওয়া হয়েছে। এই দুই অবস্থানের মধ্যে বাস্তব ভারসাম্য কতটা কার্যকর হবে, সেটি ভবিষ্যতের AI development দেখলেই আরও পরিষ্কার হবে।
আপনার কী মনে হয়—AI-এর অগ্রগতির গতি কমানো এবং একই সঙ্গে নিরাপদভাবে নতুন model প্রকাশ করা কি একসঙ্গে সম্ভব? কমেন্টে জানাতে পারেন।